Thông tin liên hệ
- 036.686.3943
- admin@nguoicodonvn2008.info
GPT-Live-1 là một trong những model AI giọng nói nổi bật, có khả năng tạo hội thoại tự nhiên và phản hồi theo thời gian thực. Tuy nhiên, chi phí thực tế không chỉ nằm ở mức giá cho lớp giọng nói mà còn có thể bao gồm model suy luận và các thành phần agent khác. Vì vậy, lựa chọn một công cụ phù hợp không chỉ phụ thuộc vào chất lượng giọng nói mà còn ở cách tính phí, khả năng tích hợp và nhu cầu triển khai.
Bài viết dưới đây tổng hợp TOP lựa chọn thay thế GPT-Live-1 đáng chú ý trong năm 2026, so sánh ưu nhược điểm và chi phí để bạn có thể đưa ra lựa chọn phù hợp với nhu cầu của mình.
Dưới đây là những lựa chọn thay thế trực tiếp. Giống GPT-Live-1, chúng là các model có thể gọi từ code của riêng bạn và phần lớn xử lý toàn bộ cuộc hội thoại thông qua một model duy nhất thay vì sử dụng một chuỗi nhiều model.
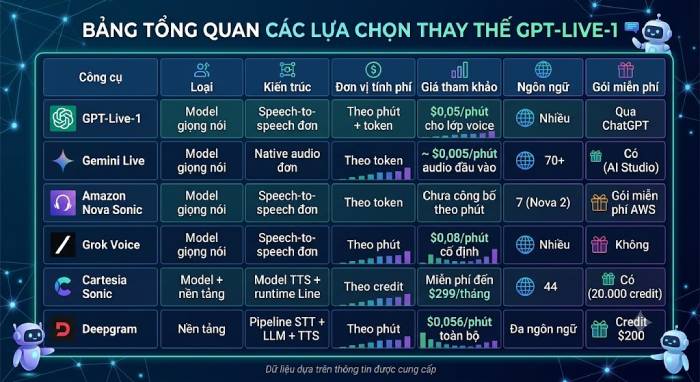
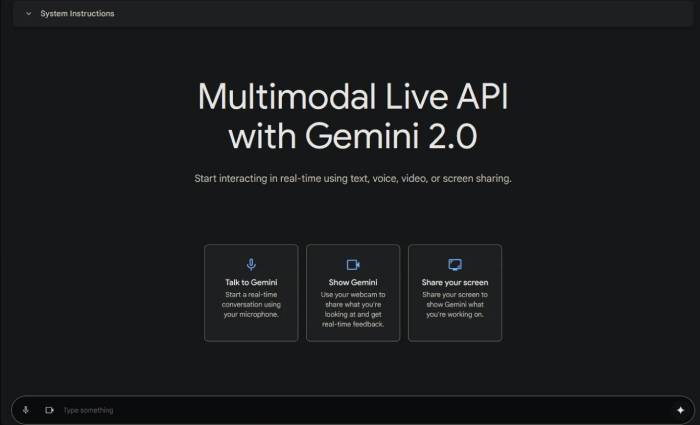
API realtime native-audio của Google và là đối thủ trực tiếp nhất của GPT-Live-1 trong nhóm các phòng lab AI lớn. API truyền dữ liệu qua WebSocket, hỗ trợ xử lý tình huống người dùng ngắt lời (barge-in). Trên model Gemini 2.5 Flash native-audio, công cụ còn hỗ trợ hội thoại theo cảm xúc (affective dialog) và âm thanh chủ động (proactive audio).
Ưu điểm:
Điểm nổi bật là phạm vi hỗ trợ rộng. Gemini Live hỗ trợ hơn 70 ngôn ngữ, function calling với Google Search được tích hợp sẵn và kết nối trực tiếp với Vertex AI cũng như AI Studio. Vì vậy, nếu hệ thống của bạn đã sử dụng Google Cloud, việc tích hợp sẽ khá đơn giản. Công cụ cũng có gói miễn phí thực sự để phát triển.
Hạn chế:
Thời lượng session bị giới hạn. Chế độ chỉ âm thanh kéo dài khoảng 15 phút, còn âm thanh kết hợp video khoảng 2 phút trước khi cần sử dụng context-window compression để kéo dài session. Google không công bố thời gian tạo âm thanh đầu tiên (time-to-first-audio), vì vậy bạn cần tự kiểm tra độ trễ thay vì dựa vào thông số có sẵn.
Giá:
Tính theo token. Với Gemini 2.5 Flash native audio, giá là $3/1 triệu token audio đầu vào và $12/1 triệu token audio đầu ra. Phiên bản Gemini 3.1 Flash Live mới hơn có mức tương đương khoảng $0,005/phút đầu vào và $0,018/phút đầu ra, khá rẻ đối với một model hàng đầu.
Phù hợp với:
Các nhóm đã sử dụng Google Cloud và muốn có mức chi phí mỗi phút thấp cùng phạm vi hỗ trợ ngôn ngữ rộng.
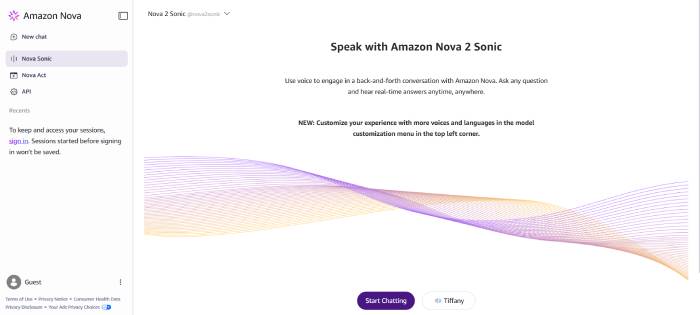
Model speech-to-speech hợp nhất của AWS trên Amazon Bedrock. Giống GPT-Live-1, Nova Sonic kết hợp khả năng hiểu và tạo giọng nói trong một model duy nhất thay vì sử dụng pipeline. Công cụ hỗ trợ streaming hai chiều, function calling và RAG để đưa kiến thức vào quá trình trả lời.
Ưu điểm:
Đây là lựa chọn phù hợp cho việc triển khai trong doanh nghiệp. Nova Sonic hoạt động bên trong Bedrock nên được hưởng các cơ chế IAM, VPC và thanh toán của AWS, đồng thời xử lý tốt tình trạng người dùng ngắt lời và tiếng ồn môi trường. Nova 2 Sonic hiện hỗ trợ 7 ngôn ngữ và context window lên tới 1 triệu token.
Hạn chế:
Có hai điểm cần lưu ý. Phiên bản Nova Sonic v1 ban đầu đã kết thúc vòng đời vào ngày 14/9/2026, vì vậy các dự án mới nên hướng tới Nova 2 Sonic. Ngoài ra, AWS không công bố mức giá đơn giản theo đô la/phút. Người dùng được tính phí dựa trên speech token và text token trên trang giá của Bedrock, khiến việc dự đoán chi phí trở nên phức tạp hơn. Số lượng khu vực hỗ trợ cũng còn hạn chế.
Giá:
Tính theo speech token và text token riêng trên Bedrock. AWS chưa công bố mức giá tổng quát theo phút, vì vậy cần tự tính toán dựa trên khối lượng sử dụng trước khi triển khai.
Phù hợp với:
Các nhóm sử dụng AWS muốn có một model S2S duy nhất trong hệ thống bảo mật và thanh toán hiện tại.
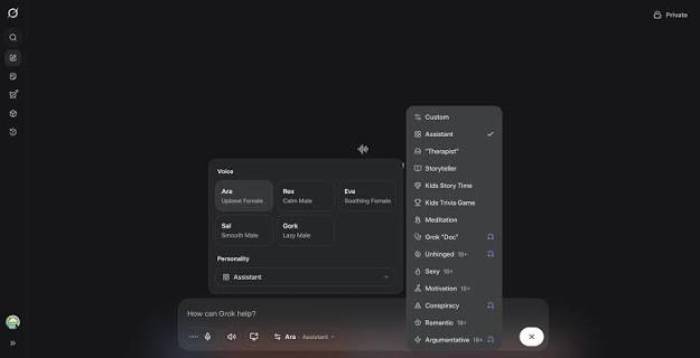
Model speech-to-speech realtime của xAI. Trong danh sách này, Grok Voice có mô hình giá gần với điều mà người dùng thực sự mong muốn nhất: đơn giản và dễ dự đoán.
Ưu điểm:
Grok Voice có giá cố định $0,08/phút. Các phép đo độc lập từ Artificial Analysis cho thấy chi phí thực tế khoảng $4,80/giờ, đúng với mức giá được công bố. Điều này đáng chú ý vì các đối thủ tính theo token thường đưa ra mức giá đầu vào rất thấp nhưng chi phí thực tế có thể cao hơn đáng kể.
Công cụ cũng hoạt động nhanh, với thời gian tạo âm thanh đầu tiên khoảng 0,70 giây, đồng thời nằm trong nhóm dẫn đầu về sự kết hợp giữa chất lượng và tốc độ.
Hạn chế:
Có một số giới hạn vận hành cứng: mặc định 10 session đồng thời cho mỗi team, thời lượng session tối đa 120 phút và chỉ hỗ trợ một khu vực us-east-1. Điện thoại (telephony) phát sinh thêm $0,01/phút đối với số điện thoại được cấp.
Ngoài ra, trên benchmark tau-Voice dành riêng cho hỗ trợ khách hàng, ngay cả cấu hình tốt nhất cũng chỉ xử lý thành công khoảng 56,5% tác vụ. Đây là một con số đáng tham khảo khi đánh giá các tuyên bố của nhà cung cấp về khả năng tự xử lý yêu cầu.
Giá:
Cố định $0,08/phút, với chi phí thực tế theo giờ tương ứng với mức giá công bố. Không có giảm giá theo sản lượng và không có làn ưu tiên tốc độ cho voice.
Phù hợp với:
Các nhóm ưu tiên hóa đơn theo phút dễ dự đoán và dễ kiểm tra hơn là mức giá token thấp nhất.
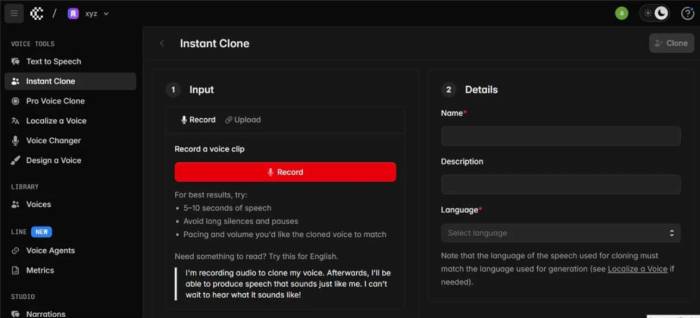
Cartesia phát triển dòng model giọng nói Sonic có độ trễ thấp. Trong năm 2026, công ty cũng cung cấp Line, một nền tảng ưu tiên code để xây dựng voice agent dựa trên các model này. Vì vậy, Cartesia vừa là nhà cung cấp model vừa ngày càng trở thành một nền tảng xây dựng agent.
Ưu điểm:
Độ trễ thấp và khả năng kiểm soát. Sonic-3.6 công bố âm thanh đầu tiên trong chưa đến 90ms, hỗ trợ 44 ngôn ngữ và có thể clone giọng nói từ đoạn âm thanh dài 10 giây.
Line là runtime thân thiện với developer, cung cấp CLI và triển khai dựa trên GitHub, phù hợp với các nhóm muốn quản lý voice agent bằng hệ thống kiểm soát phiên bản.
Hạn chế:
Công cụ tính phí theo credit thay vì phút, tạo ra một cách tính khác biệt. TTS tiêu tốn 1 credit cho mỗi ký tự, vì vậy bạn cần quy đổi theo workload thực tế để so sánh.
Cartesia chưa công bố tùy chọn self-host, vì vậy nên mặc định sử dụng cloud trừ khi có hợp đồng Enterprise.
Giá:
Miễn phí với 20.000 credit/tháng; Pro $5/tháng cho 100.000 credit; Startup $49/tháng cho 1,25 triệu credit; Scale $299/tháng cho 8 triệu credit. Tùy gói, mức này tương đương khoảng $37 - $50 cho 1 triệu ký tự.
Phù hợp với:
Các dự án nhạy cảm về độ trễ và developer muốn có workflow ưu tiên code. Nếu quan tâm cụ thể đến chất lượng giọng nói, có thể xem thêm phần so sánh Cartesia và ElevenLabs.
Deepgram là lựa chọn theo mô hình pipeline. Voice Agent API kết hợp Nova speech-to-text và Aura text-to-speech của Deepgram, đồng thời cho phép bạn tự đưa LLM vào giữa. Đây rõ ràng là pipeline STT-LLM-TTS có thể tùy chỉnh, không phải một model duy nhất.
Ưu điểm:
Người dùng có quyền kiểm soát từng thành phần, có thể thay đổi LLM, tinh chỉnh STT và self-host khi cần. Công cụ tích hợp sẵn barge-in và function calling. Tài khoản mới nhận $200 credit, đồng thời mức giá tổng thể theo phút được công bố rõ ràng, điều không phổ biến như đáng lẽ phải có.
Hạn chế:
Kiến trúc pipeline chính là điểm đánh đổi. Mỗi lần chuyển giữa các thành phần sẽ tạo thêm một chút độ trễ và khả năng phát sinh lỗi so với model đơn. LLM ở giữa cũng được tính phí riêng và Deepgram không thu khoản phí này.
Giá:
Gói Standard có giá $0,056/phút theo hình thức pay-as-you-go và Advanced là $0,122/phút, cả hai đều tăng sau ngày 12/9. Riêng Nova-3 STT có giá $0,0048/phút, còn Aura-2 TTS có giá $0,030/1.000 ký tự.
Phù hợp với:
Các nhóm muốn tự kiểm soát từng lớp trong hệ thống và sử dụng model suy luận của riêng mình.
Muốn tìm lựa chọn thay thế GPT-Live-1 gần nhất: Bắt đầu với Gemini Live hoặc Nova Sonic. Cả hai đều là model S2S đơn với sự hậu thuẫn của các phòng lab AI lớn.
Muốn chi phí dễ dự đoán: Grok Voice với mức cố định $0,08/phút hoặc Deepgram với mức công bố $0,056/phút cho toàn bộ pipeline là những lựa chọn dễ dự toán hơn.
Quan tâm đến độ trễ hoặc workflow ưu tiên code: Cartesia Sonic và Line phù hợp với kiểu triển khai này.
Công việc thực tế là xử lý ticket thay vì trả lời cuộc gọi: Một AI agent cho helpdesk ưu tiên văn bản có thể mang lại hiệu quả trực tiếp hơn bất kỳ model voice nào. Bạn cũng nên so sánh chi phí của AI agent với chi phí nhân sự trước khi quyết định triển khai.
Nguồn tin: Quantrimang.com
Ý kiến bạn đọc
Những tin mới hơn
 Mẹo bỏ qua phần trả lời AI trên Google chỉ với 3 ký tự (17/09/2026)
 Xây dựng hệ thống tạo bài thuyết trình bằng AI (20/09/2026)
 Hướng dẫn lên lịch nội dung mạng xã hội tự động bằng Manus (20/09/2026)
 Cách sử dụng plugin Claude AI cho doanh nghiệp nhỏ qua Claude for Small Business (20/09/2026)
 Hướng dẫn chỉnh sửa ảnh ChatGPT trên Canva (20/09/2026)
 Cách dùng Claude tự động quản lý Gmail: lên lịch, soạn nháp và gửi thư có kiểm soát (20/09/2026)
 Top 6 nền tảng AI hội thoại đáng dùng năm 2026 (21/09/2026)
 Sự khác biệt giữa Hub và Switch (22/09/2026)
 Cách đánh dấu vùng cần sửa ảnh trên ChatGPT (22/09/2026)
 Cách sử dụng Claude Projects: Hướng dẫn thực tế (22/09/2026)
Những tin cũ hơn
 Tính năng Dự Án trong ChatGPT là gì? Hướng dẫn sử dụng từ A đến Z (17/09/2026)
 Bộ công cụ tạo bài thuyết trình bằng AI (17/09/2026)
 TOP ứng dụng Claude AI có thể tạo mà không cần viết code (17/09/2026) AI tích hợp bảng tính: Gemini trong Sheets và Copilot trong Excel (17/09/2026)
 Xây dựng Copilot Studio agent flow đầu tiên trong 15 phút (17/09/2026)
 API Key là gì? (17/09/2026)
 Hướng dẫn tạo báo cáo tương tác trên NotebookLM (17/09/2026)
 Tại sao nên dùng AI để tạo bài thuyết trình? (17/09/2026)
 Cách dùng Perplexity làm trợ lý mua sắm cá nhân (17/09/2026)
 Gmail Live: Tìm và quản lý email bằng giọng nói (17/09/2026)
 Karaoke Người Đó Tôi Đây Tình Đâu(Midi)
 Chuyển tin nhắn Messenger thành bài hát trong nháy mắt
 Cách xây dựng game nhiều người chơi với Claude Opus 5.5
 Cách xem thời tiết trong ChatGPT với AccuWeather để lên kế hoạch
 Karaoke Lạnh (Midi)
 Cách kết nối ElevenLabs AI agent với Exa
 Thiết lập cách ChatGPT thông báo cho bạn khi có công việc cần chú ý
 TOP phần mềm OCR scan tài liệu có tích hợp AI tốt nhất
 6 trang web tạo mật khẩu ngẫu nhiên an toàn đáng tin cậy
 TOP nền tảng xây dựng công cụ nội bộ có tích hợp AI
 TOP phần mềm AI bảo mật Internet tốt nhất hiện nay
 Biến các ý tưởng thành giải thích trực quan, tương tác trong ChatGPT
 TOP tiện ích mở rộng AI cho VS Code tốt nhất
Cách tạo website Portfolio miễn phí bằng ChatGPT
 6 lựa chọn thay thế Visual Studio Code tốt nhất có tích hợp AI
 Tạo form hỏi đáp tương tác trong vài phút và prompt chỉnh sửa
 Hướng dẫn sử dụng Google Slides trong Claude
 Hướng dẫn sử dụng Wolfram trong ChatGPT giải toán nâng cao
 15 prompt AI thú vị cho ngày lễ Halloween
 Hoàn thiện một thiết kế thực tế với ChatGPT + Canva
 Hướng dẫn cài đặt và sử dụng n8n trên Windows 11
 Cách lập trình chuyên nghiệp hơn, dễ dàng hơn với tính năng Tệp trên Grok
 Công thức tính diện tích hình Elip
 Hướng dẫn ngắt kết nối ứng dụng trên ChatGPT
 Hướng dẫn tạo đoạn hội thoại cho topic trên Twee
 Bức tranh tổng quan về hỗ trợ khách hàng tích hợp AI
 Claude Code thực sự có giá bao nhiêu?
 Cách sửa lỗi There Are Currently No Power Options Available Windows
 5 tài liệu hay nhất giúp bạn làm chủ Small Language Model (SLM) năm 2026
 Hướng dẫn 8 cách mở bàn phím ảo trên Windows 10