Thông tin liên hệ
- 036.686.3943
- admin@nguoicodonvn2008.info
Dù bạn đang xây dựng ứng dụng sử dụng API LLM đơn thuần, hệ thống RAG hay các AI agent phức tạp, vẫn luôn có một câu hỏi quan trọng: làm sao để hệ thống có thể mở rộng hiệu quả? Đặc biệt, chi phí và độ trễ sẽ thay đổi thế nào khi số lượng request tăng lên?
Vấn đề này càng trở nên quan trọng với các AI agent phức tạp, nơi một truy vấn của người dùng có thể dẫn đến nhiều lần gọi LLM khác nhau. Trong thực tế, nhiều request LLM thường chứa các token đầu vào giống nhau. Người dùng thường hỏi những câu hỏi tương tự, các system prompt lặp lại trong mỗi request, và ngay cả khi tạo phản hồi, mô hình cũng phải xử lý lại nhiều token trước đó.
Chính vì vậy, caching trở thành một giải pháp quan trọng để tối ưu chi phí và độ trễ. Theo tài liệu của OpenAI, Prompt Caching có thể giảm độ trễ tới 80% và giảm chi phí token đầu vào tới 90%.
Caching không phải là khái niệm mới trong khoa học máy tính. Về cơ bản, cache là một thành phần lưu trữ tạm thời dữ liệu để phục vụ các request lặp lại nhanh hơn.
Có hai trạng thái chính của cache:
Cache hit: dữ liệu được tìm thấy trong cache, truy xuất nhanh và chi phí thấp
Cache miss: dữ liệu không có trong cache, hệ thống phải truy xuất nguồn gốc, tốn thời gian và tài nguyên hơn
Một ví dụ quen thuộc là cache của trình duyệt. Khi truy cập một website lần đầu, trình duyệt phải tải dữ liệu từ server (cache miss). Sau đó, dữ liệu được lưu vào cache. Nếu truy cập lại, trình duyệt có thể tải từ cache (cache hit), giúp trang web mở nhanh hơn và tiết kiệm tài nguyên.
Caching đặc biệt hiệu quả trong các hệ thống có dữ liệu được truy cập lặp lại. Trong thực tế, nhiều hệ thống tuân theo nguyên lý Pareto, tức khoảng 80% request thường tập trung vào 20% dữ liệu. Điều này giúp cache phát huy hiệu quả mà không cần dung lượng quá lớn.
Để hiểu Prompt Caching, cần hiểu cách LLM tạo phản hồi. Quá trình inference của LLM thường gồm hai giai đoạn:
Pre-fill
Ở bước này, mô hình xử lý toàn bộ prompt để tạo token đầu tiên. Đây là giai đoạn cần tính toán nặng.
Decoding
Sau đó, mô hình tạo token tiếp theo theo kiểu autoregressive, nghĩa là mỗi token mới phụ thuộc vào các token trước đó.
Ví dụ với prompt:
"What should I cook for dinner?"Mô hình có thể tạo phản hồi từng bước như:
Here
Here are
Here are 5
Here are 5 easy
Here are 5 easy dinner ideas
Vấn đề là mỗi lần tạo token mới, mô hình phải xử lý lại toàn bộ token trước đó, gây lãng phí tài nguyên.
Để giải quyết vấn đề này, LLM sử dụng KV caching . Các tensor trung gian được lưu lại để tránh tính toán lại từ đầu. Tuy nhiên, KV caching chỉ hoạt động trong một prompt duy nhất.
Prompt Caching mở rộng cơ chế này sang nhiều prompt khác nhau.
Prompt Caching lưu lại các phần lặp lại của prompt, thường là:
system prompt
hướng dẫn cố định
context từ RAG
Khi request mới có cùng prefix, mô hình sẽ tái sử dụng các tính toán trước đó thay vì xử lý lại từ đầu. Điều này giúp giảm chi phí và độ trễ đáng kể.
Điểm quan trọng là caching hoạt động ở token level . Nghĩa là nếu hai prompt có cùng prefix, phần đó có thể được cache.
Ví dụ:
Prompt 1
What should I cook for dinner?
Prompt 2
What should I cook for lunch?Trong trường hợp này, phần "What should I cook" sẽ được cache.
Tuy nhiên:
Prompt 1
Dinner time! What should I cook?
Prompt 2
Lunch time! What should I cook?Hai prompt này sẽ không cache được vì prefix khác nhau.
Do đó, một nguyên tắc quan trọng là:
Thông tin cố định đặt ở đầu prompt
Thông tin thay đổi đặt ở cuối prompt
Hiện nay, nhiều mô hình như GPT hoặc Claude đã hỗ trợ Prompt Caching trực tiếp trong API. Cache thường được chia sẻ giữa các user trong cùng tổ chức sử dụng chung API key.
Điều này đặc biệt hữu ích trong môi trường doanh nghiệp, nơi nhiều người dùng sử dụng cùng ứng dụng và cùng prefix.
Một số tùy chọn caching phổ biến gồm:
In-memory cache: giữ cache từ 5–60 phút
Extended cache: giữ cache tới 24 giờ (tùy model)
Chúng ta có thể thấy tất cả những điều này trong thực tế với ví dụ Python tối thiểu sau đây, thực hiện các yêu cầu đến API của OpenAI, sử dụng Prompt Caching và các lời nhắc nấu ăn đã đề cập trước đó. Tôi đã thêm một tiền tố chung khá lớn vào các lời nhắc của mình để làm cho hiệu quả của việc lưu vào bộ nhớ đệm trở nên rõ ràng hơn:
from openai import OpenAI
api_key = "your_api_key"
client = OpenAI(api_key=api_key)

prefix = """
You are a helpful cooking assistant.

Your task is to suggest simple, practical dinner ideas for busy people.
Follow these guidelines carefully when generating suggestions:

General cooking rules:
- Meals should take less than 30 minutes to prepare.
- Ingredients should be easy to find in a regular supermarket.
- Recipes should avoid overly complex techniques.
- Prefer balanced meals including vegetables, protein, and carbohydrates.

Formatting rules:
- Always return a numbered list.
- Provide 5 suggestions.
- Each suggestion should include a short explanation.

Ingredient guidelines:
- Prefer seasonal vegetables.
- Avoid exotic ingredients.
- Assume the user has basic pantry staples such as olive oil, salt, pepper, garlic, onions, and pasta.

Cooking philosophy:
- Favor simple home cooking.
- Avoid restaurant-level complexity.
- Focus on meals that people realistically cook on weeknights.

Example meal styles:
- pasta dishes
- rice bowls
- stir fry
- roasted vegetables with protein
- simple soups
- wraps and sandwiches
- sheet pan meals

Diet considerations:
- Default to healthy meals.
- Avoid deep frying.
- Prefer balanced macronutrients.

Additional instructions:
- Keep explanations concise.
- Avoid repeating the same ingredients in every suggestion.
- Provide variety across the meal suggestions.

""" * 80
# huge prefix to make sure i get the 1000 something token threshold for activating prompt caching

prompt1 = prefix + "What should I cook for dinner?"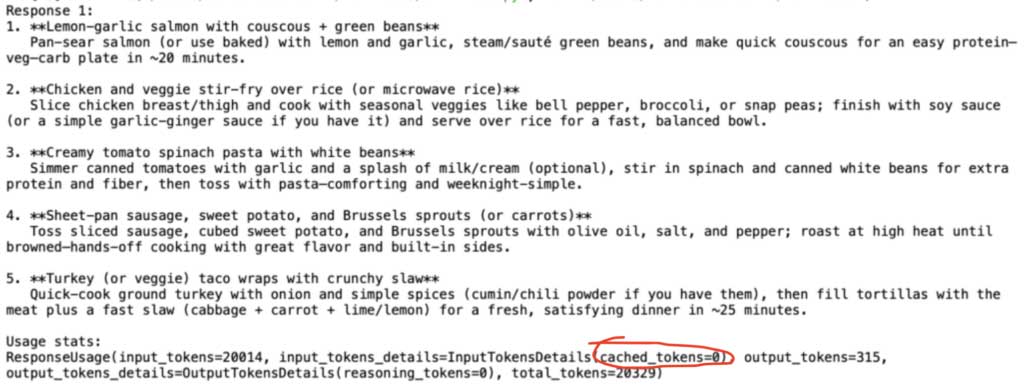
Và sau đó đến prompt 2:
prompt2 = prefix + "What should I cook for lunch?"

response2 = client.responses.create(
    model="gpt-5.2",
    input=prompt2
)

print("\nResponse 2:")
print(response2.output_text)

print("\nUsage stats:")
print(response2.usage)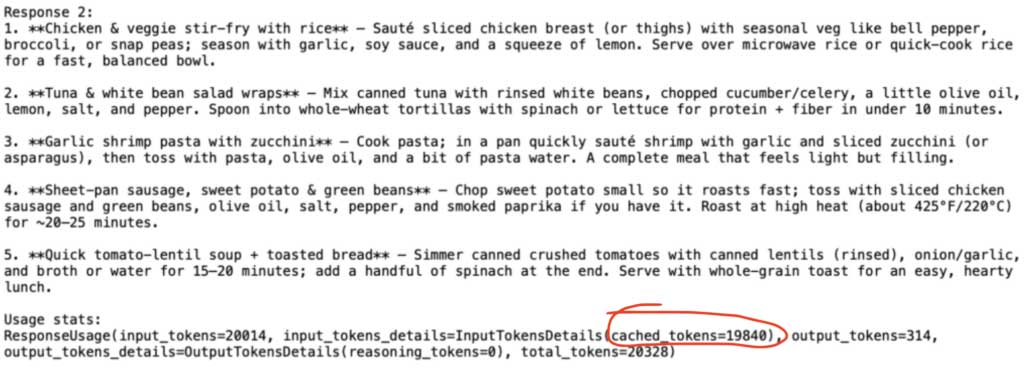
Như vậy, đối với prompt số 2, chúng ta sẽ chỉ bị tính phí đầy đủ cho phần còn lại, không giống hệt với prompt đó. Đó sẽ là số token đầu vào trừ đi số token đã được lưu vào bộ nhớ cache: 20.014 – 19.840 = chỉ 174 token, hay nói cách khác, ít hơn 99% số token mà chúng ta bị tính giá đầy đủ. Đối với các token còn lại được lưu vào bộ nhớ cache, chúng ta được hưởng mức giá chiết khấu cực kỳ cao (như được giảm giá lên đến 90%).
Trong mọi trường hợp, vì OpenAI áp đặt ngưỡng tối thiểu 1.024 token để kích hoạt tính năng lưu vào bộ nhớ cache lời nhắc và bộ nhớ cache có thể được lưu giữ tối đa 24 giờ, nên rõ ràng là những lợi ích về chi phí đó chỉ có thể đạt được trong thực tế khi chạy các ứng dụng AI ở quy mô lớn, với nhiều người dùng hoạt động thực hiện nhiều yêu cầu mỗi ngày. Tuy nhiên, như đã giải thích cho những trường hợp như vậy, tính năng Lưu vào Bộ nhớ Caching Lời nhắc có thể mang lại lợi ích đáng kể về chi phí và thời gian cho các ứng dụng được hỗ trợ bởi LLM.
Tổng token: 20.014
Token cache: 19.840
Token tính phí đầy đủ: 174
Điều này tương đương giảm 99% token tính phí đầy đủ .
Tuy nhiên, OpenAI yêu cầu tối thiểu 1.024 token để kích hoạt Prompt Caching và cache tối đa 24 giờ. Vì vậy, lợi ích lớn nhất xuất hiện khi hệ thống có quy mô lớn và nhiều request.
Prompt Caching là một kỹ thuật tối ưu mạnh mẽ giúp giảm chi phí và độ trễ của hệ thống LLM. Bằng cách tái sử dụng các phần prompt lặp lại, hệ thống có thể tránh tính toán dư thừa và cải thiện hiệu suất.
Khi ứng dụng AI ngày càng mở rộng, đặc biệt trong các hệ thống RAG hoặc multi-agent, Prompt Caching sẽ trở thành một yếu tố quan trọng để đảm bảo khả năng mở rộng và tối ưu chi phí lâu dài.
Nguồn tin: Quantrimang.com
Ý kiến bạn đọc
Những tin mới hơn
 Hướng dẫn tạo câu hỏi ôn tập bằng Perplexity AI (04/04/2026)
 Cách tạo sơ đồ tư duy bằng Canva AI (04/04/2026)
 Hướng dẫn tạo video bài giảng bằng Canva AI trong 5 phút (04/04/2026)
 Mẫu prompt kiểm tra khả năng truy cập cho code (04/04/2026)
 Hướng dẫn tách các thành phần trong ảnh trên Canva (04/04/2026)
 Hướng dẫn kết nối MCP Github Local Dev với Claude AI: Chi tiết từng bước cho người mới bắt đầu (04/04/2026)
 3 công cụ AI của Google có thể giúp bạn tìm công việc mới phù hợp (05/04/2026)
 Mẹo tự động làm mờ nền ảnh trên Microsoft Designer (05/04/2026)
 Mẫu prompt phân tích dấu vết ngăn xếp (stack trace) (05/04/2026)
 6 mẹo giúp tận dụng tối đa Gemini Deep Research (05/04/2026)
Những tin cũ hơn
 Tại sao chúng ta lại mất dần năng lực tự yêu chính mình? (03/04/2026)
 Mẫu prompt đánh giá code toàn diện (03/04/2026)
 Cách vô hiệu hóa update driver tự động trên máy tính (03/04/2026)
 Mẫu prompt tối ưu hóa hiệu suất code (03/04/2026)
 Cách khôi phục giao diện màu xanh cho PowerShell (03/04/2026)
 Mẫu prompt kiểm tra bảo mật code (03/04/2026)
 Hướng dẫn tạo skill nhanh dành cho người mới (03/04/2026)
 Mẫu prompt tái cấu trúc code (03/04/2026)
 Hướng dẫn tạo phiếu trò chơi ghép nối bằng Gemini (03/04/2026)
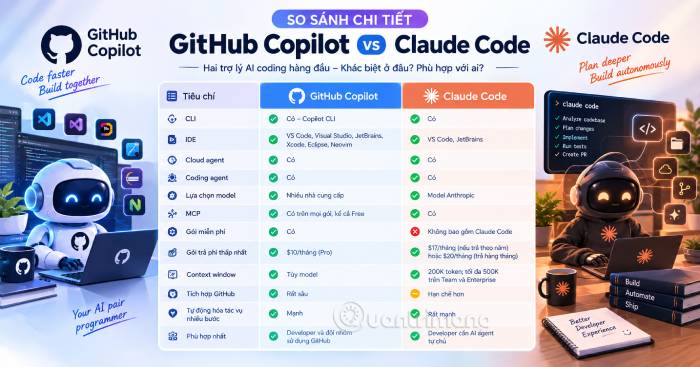 GitHub Copilot vs Claude Code: So sánh tính năng, giá và khả năng AI coding
 Các workflow và giới hạn thực tế trong OpenAI Decisions API
 6 trình duyệt có những tính năng AI tốt nhất
 TOP những trợ lý email AI tốt nhất
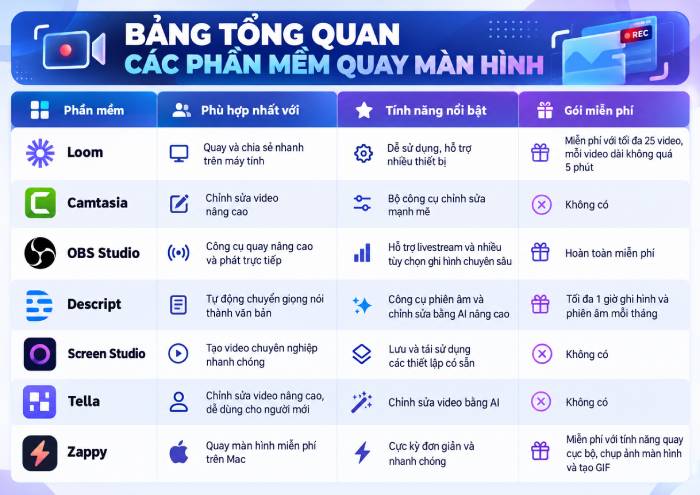 TOP phần mềm quay màn hình có hỗ trợ AI
 Cách cá nhân hóa hành vi agent trong ElevenAgents
 Hướng dẫn tìm lịch sử trò chuyện với Canva AI
 Hướng dẫn dùng HyperFrames & ChatGPT tạo kịch bản làm video từ dữ liệu tải lên
 Hướng dẫn tạo tác vụ theo lịch trong Canva AI
 [Video] Cách kết nối Plugin Notion trên ChatGPT và sử dụng cơ bản
 Tạo bản tóm tắt thiết kế trong OpenAI Decisions API
 Canvas trong Google Search: Viết, lập kế hoạch và lập trình ứng dụng
 Cách cá nhân hóa hành vi agent trong ElevenAgents
 TOP phần mềm quay màn hình có hỗ trợ AI
 Dùng AI để giao việc cho nhân viên: Nhập CSV vào Notion và ra lệnh bằng ChatGPT
 TOP nền tảng quản lý chi phí AI và Cloud tốt nhất
 Cách tạo công cụ lập kế hoạch tương tác bằng ChatGPT
 Tìm hiểu về Vane: Phiên bản thay thế mã nguồn mở cho Perplexity
 Câu hỏi dạng điểm số trong OpenAI Decisions API: Đánh giá dựa trên thang điểm do bạn tự xác định
 Hướng dẫn tạo công cụ quản lý tài chính với ChatGPT Intelligent UI
 Hướng dẫn cài đặt và sử dụng n8n trên Windows 11
 Cách lập trình chuyên nghiệp hơn, dễ dàng hơn với tính năng Tệp trên Grok
 Công thức tính diện tích hình Elip
 Hướng dẫn ngắt kết nối ứng dụng trên ChatGPT
 Hướng dẫn tạo đoạn hội thoại cho topic trên Twee
 Bức tranh tổng quan về hỗ trợ khách hàng tích hợp AI
 Cách sửa lỗi There Are Currently No Power Options Available Windows
 6 cách mở Computer/System Properties trong Windows 10
 Hướng dẫn 8 cách mở bàn phím ảo trên Windows 10
 Hướng dẫn tạo flashcard trên Canva AI